Article d’archive. Texte préparé le 30 octobre 2026, mis en ligne le 7 novembre 2026.
Une réponse fluide en français ou en arabe peut s’appuyer sur le mauvais document. Un protocole RAG multilingue doit vérifier le passage retrouvé, la fidélité de la réponse et la capacité à reconnaître qu’une preuve manque.
Le RAG, ou génération augmentée par recherche documentaire, ajoute au modèle des passages retrouvés dans une base de connaissances. Il peut servir à consulter des procédures POS, des fiches techniques ou des informations d’accueil. Mais une réponse fluide ne démontre ni la qualité de la recherche ni la fidélité aux documents. Deux travaux présentés à EMNLP, du 24 au 29 octobre 2026, donnent des pistes pour construire des tests plus utiles.
Ce que les travaux récents permettent de comprendre
Dans The Language of Evidence, Hira, Mire et Sap étudient les requêtes mêlant plusieurs langues. Ils montrent que les performances habituelles de recherche peuvent masquer une préférence linguistique, notamment pour des documents anglais. Leur corpus inclut le français, mais pas l’arabe ni la darija : appliquer cette observation au contexte marocain constitue donc une hypothèse à tester localement, et non un résultat déjà démontré pour ces langues.
Le travail The RAT, de von Däniken et ses collègues, distingue la réussite de la réponse du comportement du générateur face aux documents retrouvés. Une bonne réponse obtenue sans preuve suffisante n’équivaut pas à un système qui respecte sa politique documentaire. Les auteurs séparent notamment recherche, abstention et exactitude. Le protocole ci-dessous s’inspire de cette distinction ; il s’agit d’une proposition pratique, pas d’une reproduction de leurs expériences.
Commencer par une petite base vérifiable
Pour un premier essai, choisissez un périmètre limité : dix à vingt procédures de support, ou une dizaine de fiches décrivant des prestations. Affectez à chaque document un identifiant, une langue, un responsable, une date de mise à jour et, lorsque nécessaire, une période de validité. Conservez la correspondance entre chaque passage indexé et son document d’origine.
Évitez de mélanger les règles validées, les anciennes offres et les notes de travail dans un même ensemble sans statut. Pour les besoins du test, une fiche fictive peut indiquer qu’un service est disponible uniquement le samedi. Une autre peut décrire une intervention réservée à une version précise d’un logiciel. Ces contraintes simples permettent de repérer rapidement les réponses qui extrapolent.
Construire des questions équivalentes en plusieurs langues
Préparez douze intentions métier, puis déclinez chacune en français, en arabe et dans une formulation mixte réellement plausible. Cela donne trente-six cas de départ : un choix de taille pour ce pilote, sans valeur de seuil scientifique. Faites relire les formulations arabes et mixtes par une personne qui les utilise effectivement.
Exemple fictif : « Le service est-il disponible dimanche ? », « واش الخدمة متوفرة نهار الحد؟ », puis « Le service disponible dimanche ولا غير السبت؟ ». Le dossier de référence indique seulement le samedi. Pour les trois variantes, le système doit retrouver cette règle et expliquer que le dimanche n’est pas confirmé. Traduire correctement la question tout en ignorant la restriction constitue un échec.
Ajoutez des variantes de vocabulaire, d’orthographe et d’écriture latine lorsque celles-ci correspondent aux usages des clients. Ne transformez pas automatiquement toutes les questions en anglais sans comparer les résultats : vous risqueriez de masquer les difficultés propres aux formulations d’origine.
Séparer la recherche de la rédaction
Pour chaque question, inspectez d’abord les passages fournis au modèle. Contiennent-ils toutes les informations nécessaires ? Leur version est-elle applicable ? Ensuite seulement, évaluez la réponse : respecte-t-elle la contrainte, indique-t-elle sa source et évite-t-elle d’ajouter un tarif, une disponibilité ou une compatibilité absente du dossier ?
Consignez les résultats dans une feuille simple : identifiant du cas, langue, documents attendus, passages obtenus, réponse, verdict et commentaire. Distinguez trois causes d’échec : document utile non retrouvé, preuve retrouvée mais mal utilisée, question impossible à trancher avec les données disponibles. Chaque cause appelle une correction différente.
Calculez les résultats par langue et par type de question. Une moyenne globale favorable peut cacher un problème systématique sur les messages mixtes ou les demandes comportant deux contraintes. Si un autre modèle aide à noter les réponses, faites contrôler un échantillon par un humain : l’évaluateur automatique doit lui aussi être vérifié.
Tester les cas où l’assistant doit s’arrêter
Retirez volontairement la fiche qui contient la réponse et rejouez le cas. L’assistant doit signaler l’information manquante, plutôt que proposer une réponse plausible. Présentez ensuite deux fiches contradictoires, sans règle permettant de les départager : le résultat attendu est l’explication du conflit et une demande de validation.
Testez aussi une ancienne fiche encore présente dans l’index. La date doit participer à la sélection des preuves ; afficher une citation ne suffit pas si cette citation renvoie à une règle dépassée. Enfin, séparez information et action : rédiger une réponse sur une annulation ne doit pas annuler une réservation. Ce pilote documentaire peut rester entièrement en lecture seule.
Décider du déploiement à partir des échecs observés
Fixez les critères avant le test. Par exemple, toute invention d’un prix ou toute confusion de version bloque le passage en production sur le périmètre concerné. Vérifiez aussi que le système sait répondre lorsque la preuve est suffisante : une abstention systématique serait peu utile. Ces choix dépendent du métier et ne constituent pas une garantie universelle.
Conservez les versions du modèle, de l’index, des paramètres de recherche et des consignes avec les résultats. Rejouez les cas après chaque changement important. L’objectif est de disposer d’un assistant dont les réponses sont contrôlables et dont les limites sont visibles, dans les langues réellement employées par ses utilisateurs.
Références
Hira, Mire et Sap — The Language of Evidence: Robustness and Bias in Code-Switched RAG, EMNLP, 24–29 octobre 2026. Texte intégral.
von Däniken, Saaro, Cieliebak et Deriu — The RAT: A Unified Bayesian Model for RAG Evaluation, EMNLP, 24–29 octobre 2026. Texte intégral.
Dans les archives Geekkech. Développer une caisse utile : le terrain avant les fonctionnalités.
Le fonctionnement en images
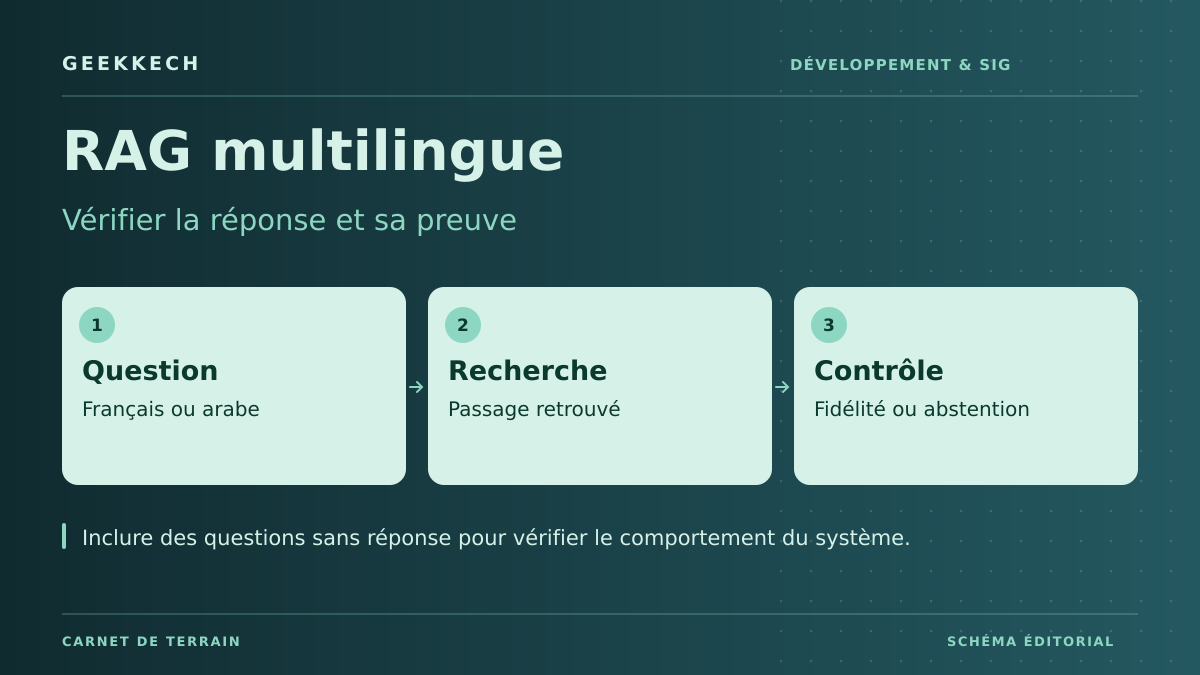
Exemple à reproduire
| Question de test | Résultat à vérifier |
|---|---|
| Tarif en français puis en arabe | Même information et même version du document |
| Question avec un nom de prestation anglais | Passage métier pertinent retrouvé |
| Question absente des documents | Limite annoncée et absence de réponse inventée |