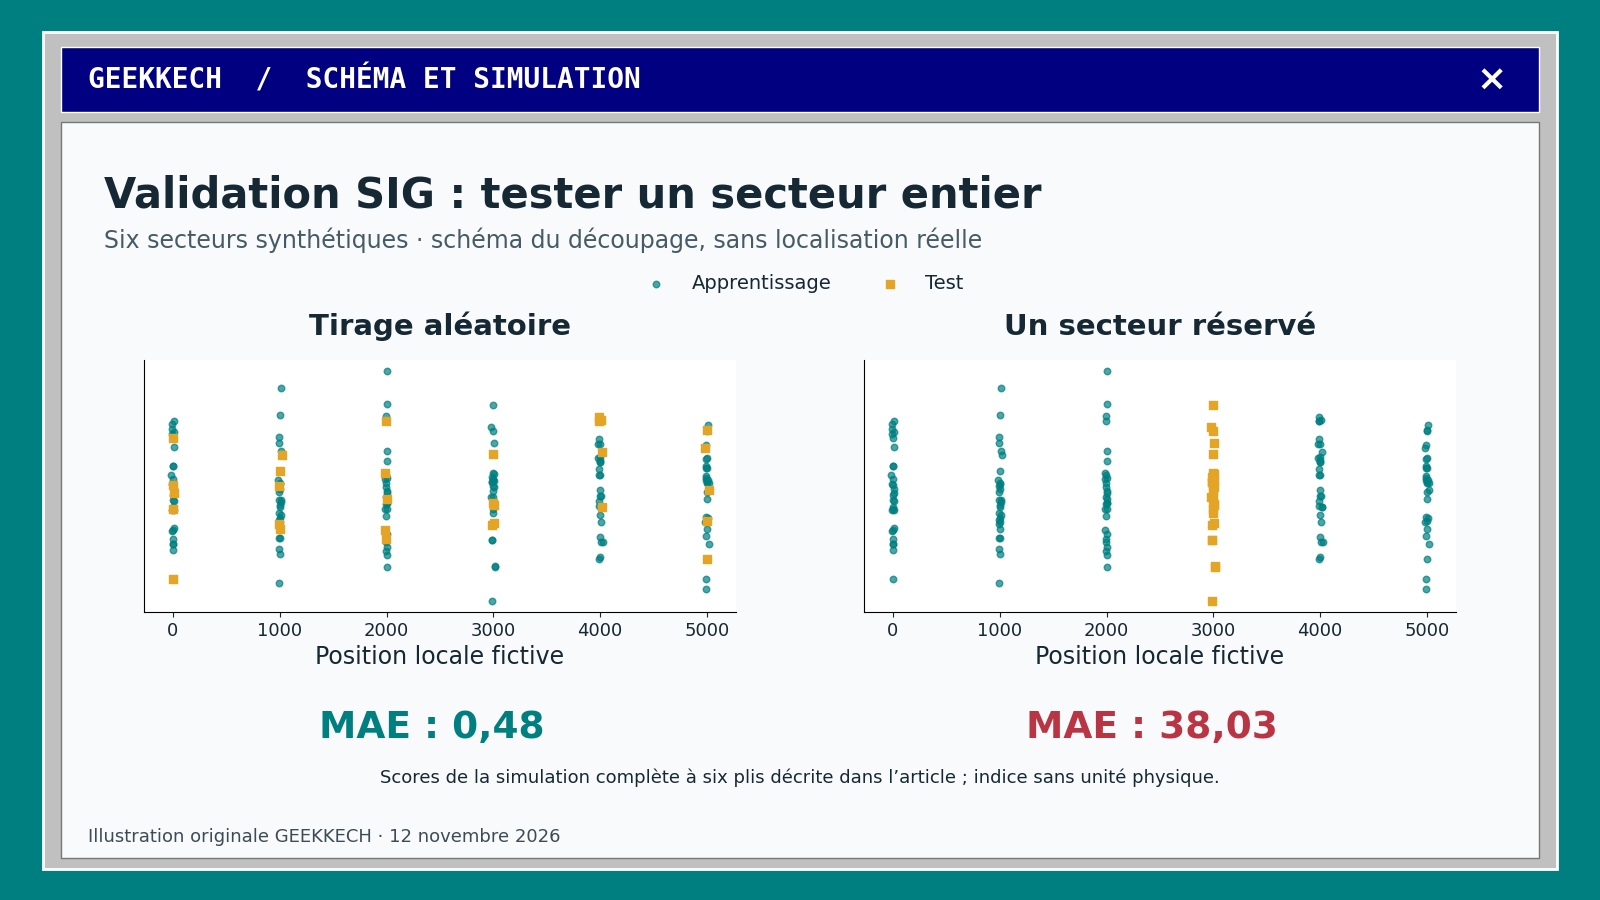
Illustration originale GEEKKECH. Schéma d’un pli de test et scores de la simulation complète de l’article. Les points sont fictifs et ne représentent aucun réseau réel.
Texte rédigé le 12/11/2026. La date affichée correspond à la rédaction. Mise en ligne ultérieure.
Un modèle apprend à estimer une mesure à partir de points cartographiés. Son erreur paraît faible, puis augmente dès qu’une équipe l’utilise dans un quartier encore peu documenté. Le découpage entre apprentissage et test peut expliquer cet écart. Si les deux ensembles contiennent des points voisins, le score mesure surtout la capacité à interpoler à proximité des observations connues. Pour préparer une extension géographique, réservez des secteurs entiers à l’évaluation.
Ce dossier s’appuie sur des publications de septembre et octobre 2026, dans une fenêtre de recherche élargie à trois mois. Le 7 octobre, CRAN a publié spatialcvR 0.1.0, de Mamadou Sow. Sa documentation du 26 septembre décrit des découpages par blocs, avec zone tampon ou par regroupement spatial. Ce sont des outils pour construire une évaluation adaptée au terrain. Notice CRAN, 7 octobre 2026 · Documentation de l’auteur, 26 septembre 2026.
Choisir le test selon la décision attendue
Compléter une carte dans un secteur déjà échantillonné et prédire dans une zone nouvelle posent deux problèmes différents. Dans le premier cas, la proximité de points connus appartient aux conditions d’utilisation. Dans le second, le modèle doit fonctionner malgré cette absence. Décrivez donc d’abord le territoire et la période où les prévisions seront utilisées, puis construisez le test correspondant.
Une étude de Chun-ya Liu, publiée le 26 octobre 2026 dans ICCK Journal of Image Analysis and Processing, compare six classifieurs pour cartographier l’occupation du sol à Taipei. Les polygones de référence restent entiers lors des séparations entre apprentissage et validation. Le texte comporte des dates de réception et d’acceptation, ainsi qu’un statut d’article de recherche publié en revue. Article et dates éditoriales.
Les auteurs soulignent que de nombreux pixels issus des mêmes polygones apportent moins d’information indépendante que leur nombre brut ne le laisse penser. Leur échantillon de référence est toutefois construit de manière raisonnée, avec des polygones dessinés à la main. Le texte précise que leur représentativité sur l’ensemble de la ville reste une limite. Le regroupement améliore le protocole, sans résoudre à lui seul les biais de collecte. Texte intégral, sections 3.4 et 5.6, 26 octobre 2026.
Une simulation Python entièrement fictive
Créons six secteurs alignés, espacés de 1 000 unités, contenant chacun trente points. Chaque secteur possède un niveau de mesure arbitraire, auquel s’ajoute un faible bruit. Les coordonnées sont locales et synthétiques. Elles ne décrivent aucune installation ni aucun territoire réel. La variable à prédire est un indice sans unité physique.
Le modèle utilise les trois points d’apprentissage les plus proches. Nous comparons six plis aléatoires à six plis réservant chacun un secteur entier. Le code a été exécuté avec Python 3.12.14, NumPy 2.3.5 et scikit-learn 1.8.0. Enregistrez-le dans un fichier Python et lancez-le dans un environnement disposant de ces dépendances.
import numpy as np
from sklearn.metrics import mean_absolute_error
from sklearn.model_selection import GroupKFold, KFold
from sklearn.neighbors import KNeighborsRegressor

rng = np.random.default_rng(42)
secteurs = np.repeat(np.arange(6), 30)
x = secteurs * 1000 + rng.normal(0, 10, 180)
y = rng.normal(0, 10, 180)
coordonnees = np.column_stack((x, y))
niveaux = np.array([10, 40, 15, 80, 30, 60])
mesure = niveaux[secteurs] + rng.normal(0, 0.5, 180)

protocoles = {
    'Tirage aleatoire': KFold(6, shuffle=True, random_state=42).split(coordonnees),
    'Secteur entier reserve': GroupKFold(6).split(coordonnees, mesure, secteurs),
}
for nom, decoupages in protocoles.items():
    predictions = np.empty_like(mesure)
    for apprentissage, test in decoupages:
        modele = KNeighborsRegressor(n_neighbors=3)
        modele.fit(coordonnees[apprentissage], mesure[apprentissage])
        predictions[test] = modele.predict(coordonnees[test])
    erreur = mean_absolute_error(mesure, predictions)
print(f'{nom} : MAE = {erreur:.2f}')| Découpage | Erreur absolue moyenne |
|---|---|
| Tirage aléatoire | 0,48 |
| Secteur entier réservé | 38,03 |
La MAE est la moyenne des écarts absolus entre mesure et prédiction. Chaque point reçoit ici une prédiction hors apprentissage. Le tirage aléatoire permet généralement au modèle de retrouver des voisins du même secteur. Quand un secteur entier disparaît de l’apprentissage, ses niveaux arbitraires deviennent difficiles à déduire. Le jeu est volontairement construit pour rendre ce mécanisme visible. Les valeurs obtenues ne prédisent pas l’écart d’erreur d’un projet réel.
GroupKFold maintient chaque groupe dans un seul ensemble de test et évite son chevauchement avec l’apprentissage du même pli. Il n’impose aucune distance minimale entre groupes. Deux secteurs limitrophes peuvent conserver des points très proches. Documentation officielle scikit-learn 1.8.0, consultée le 12 novembre 2026.
Passer du jeu fictif à une collecte de terrain
Définissez les groupes avant de comparer les modèles, selon l’usage visé. Un identifiant de site, de tronçon ou de zone de collecte peut servir si cette unité correspond réellement à une dépendance des observations. Pour une étude spatiale, examinez aussi les distances entre les points d’apprentissage et de test. Une zone tampon peut exclure les voisins trop proches, au prix d’un échantillon d’apprentissage plus petit.
Préservez également la chronologie lorsque l’objectif porte sur une période future. Un secteur absent de l’apprentissage teste un transfert géographique. Une date future teste une évolution temporelle. Les combiner peut être nécessaire, avec un effectif plus faible. Conservez les variables effectivement disponibles au moment où la décision sera prise et documentez la date de chaque mesure.
Ajustez imputation, normalisation et sélection de variables uniquement sur l’apprentissage de chaque pli. Une Pipeline aide à appliquer cette règle. Réservez un test final indépendant des choix de modèle et de paramètres. Guide officiel scikit-learn 1.8.0 sur les fuites d’information, consulté le 12 novembre 2026.
Rapporter les erreurs et les zones mal couvertes
Le rapport opérationnel indique la cible, la période, les secteurs retenus, les effectifs, les distances de séparation et l’erreur par secteur. Comparez le modèle à une référence simple, comme la moyenne de l’apprentissage, sur les mêmes plis. Cartographiez les erreurs et signalez les zones dont les caractéristiques sortent du domaine observé. Fixez avec les utilisateurs un seuil d’erreur acceptable avant la mise en service.
Un mauvais résultat sur une zone entière peut révéler une collecte insuffisante ou l’absence d’une variable explicative. Il peut aussi correspondre à une extrapolation plus difficile que l’usage prévu. Ce diagnostic demande de revoir le protocole et les données. La qualité des coordonnées et la cohérence du réseau restent des préalables. Contrôler les coordonnées avant import · Vérifier la connectivité d’un réseau.