Une démo créée avec un agent de code transforme un fichier en tableau et affiche trois graphiques. Tout fonctionne avec le jeu de données du développeur. Le lendemain, un utilisateur importe deux fois le même fichier et voit les données d’un autre compte. Le problème apparaît à l’étape où l’application doit résister à des usages ordinaires. La recette doit donc tester ce qui arrive aux données quand les utilisateurs sortent du scénario de présentation.
Limiter les effets du prototype
Pour un tableau de suivi d’achats, créez deux entreprises fictives et trois profils. Un opérateur importe et corrige ses documents. Un responsable valide les écritures. Un lecteur consulte uniquement les données de son entreprise. Les règles sont contrôlées côté serveur, y compris lorsqu’une requête est construite à la main ou qu’un identifiant est modifié dans l’URL.
Gardez les clés d’API côté serveur et limitez les permissions de l’agent. Un fichier importé peut contenir une instruction visant à faire divulguer des données ou changer un résultat. Traitez le contenu extrait comme une donnée non fiable. Les opérations sensibles restent soumises à un contrôle applicatif et à une validation explicite.
Tester six échecs qui changent le résultat
Exécutez chaque cas sur une copie séparée. Un compte tente de lire la fiche d’un autre compte. Le même fichier est importé deux fois. Une validation arrive en double à la suite d’un délai réseau. Un document incomplet contient un total illisible. Le fournisseur d’IA ne répond plus. Enfin, une restauration est effectuée avec une sauvegarde et le nombre de fiches est comparé au relevé de départ.
Pour chaque cas, notez les données d’entrée, le résultat attendu et l’état final de la base. Par exemple, rejouer une requête après un délai doit renvoyer la même référence et conserver une seule écriture. Une erreur détectée par l’interface suffit rarement à prouver l’intégrité des données.
Mesurer la dépendance au fournisseur
Relevez le temps de réponse et le coût par dossier sur plusieurs formats. Ajoutez un plafond d’usage et prévoyez un état de reprise quand le fournisseur est indisponible. La documentation de déploiement doit permettre à une autre personne de restaurer le système et d’identifier les services qui facturent à l’usage.
Le cadre SSDF du NIST propose d’intégrer ces pratiques au cycle de développement. OWASP décrit les risques propres aux applications à modèles de langage, notamment l’injection d’instructions et la divulgation de données sensibles. L’étude Understanding the (In)Security of Vibe-Coded Applications apporte des observations sur un échantillon d’applications. Il s’agit d’une prépublication. Son périmètre ne permet pas d’estimer le taux de failles de tous les projets.
Préparer une livraison reproductible
La livraison associe une version identifiable, un jeu de données de recette, les procédures d’installation et de restauration, et la liste des limitations observées. Le client doit pouvoir refaire les cas critiques avec son propre jeu de test. Cette recette peut faire partie du devis du pilote d’automatisation.
Sources
NIST SP 800-218, Secure Software Development Framework, version 1.1, 2022
OWASP, Top 10 pour les applications utilisant des modèles de langage
Understanding the (In)Security of Vibe-Coded Applications, prépublication arXiv, 2026
Le fonctionnement en images
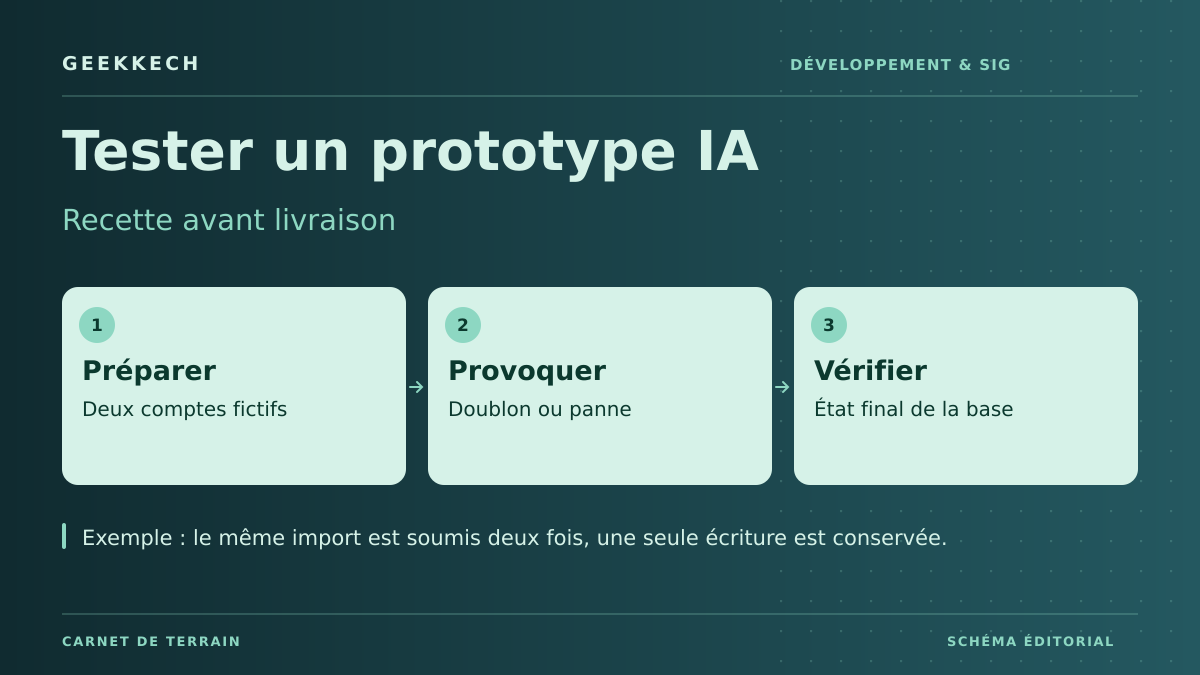
Exemple à reproduire
| Tentative | Résultat à vérifier |
|---|---|
| Un compte lit la fiche d’un autre compte | Accès refusé côté serveur |
| Le même fichier est envoyé deux fois | Une seule écriture dans la base |
| Le fournisseur IA ne répond plus | État d’erreur explicite et reprise contrôlée |