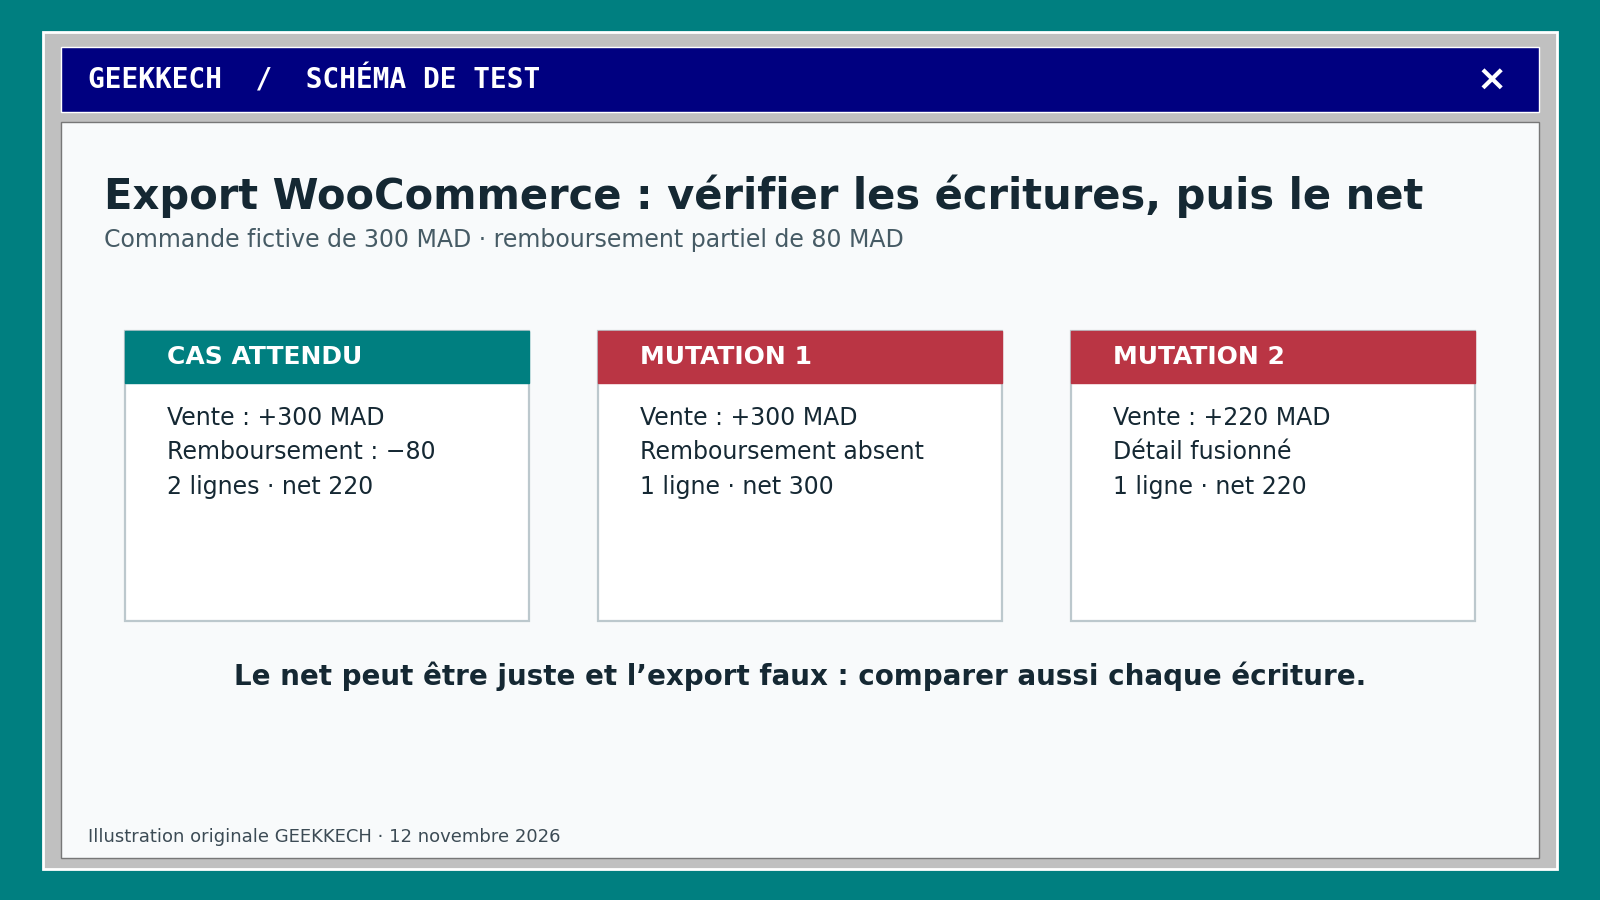
Illustration originale GEEKKECH. Schéma des tests de régression : le bon total ne garantit pas un export correct. Les deux mutations doivent échouer.
Texte rédigé le 07/11/2026. La date affichée correspond à la rédaction. Mise en ligne ultérieure.
Une agence livre à plusieurs boutiques un plugin qui exporte les commandes WooCommerce vers un logiciel de gestion. Une mise à jour modifie le traitement des remboursements. L’export produit toujours un fichier et l’écran de suivi reste au vert. Pourtant, un remboursement disparaît du fichier utilisé pour le rapprochement. La prestation de maintenance consiste à vérifier ce scénario à chaque version prise en charge, à rendre les échecs visibles et à distinguer le diagnostic de la correction. Un agent de programmation peut aider à trier les alertes. Le test fournit la preuve.
Deux annonces GitHub qui changent le travail de maintenance
Le 2 novembre 2026, GitHub a annoncé que les dépôts publics seraient
soumis par défaut au blocage du déclencheur
pull_request_target à partir du 2 décembre, sauf
autorisation explicite par une politique applicable. Des fenêtres
temporaires sont annoncées les 9 et 16 novembre. Un plugin publié sur
GitHub peut donc perdre une partie de ses vérifications s’il dépend de
ce déclencheur. Le premier travail consiste à inventorier les usages, à
consulter les alertes de politique du dépôt et à distinguer les tests
ordinaires des tâches qui ont réellement besoin d’un accès privilégié.
Annonce
GitHub, 2 novembre 2026, anglais · Documentation
de sécurité, allemand
Le 5 novembre, GitHub a ajouté un taux de prise en compte des commentaires de Copilot aux rapports par dépôt des organisations et entreprises. Une réponse qui reporte une correction à une autre pull request peut entrer dans le numérateur. Les commentaires sont évalués à la fusion. Un taux élevé dit donc quelque chose sur le traitement des retours. Pour savoir si le correctif protège l’export des remboursements, il faut relancer le scénario concerné. Annonce GitHub, 5 novembre 2026, anglais
Une preuve de compatibilité que le client peut relire
Prenons une boutique fictive avec une commande de 300 MAD et un remboursement partiel de 80 MAD, frais et taxes exclus du scénario. Le fichier d’échange convenu doit contenir deux écritures, une vente de 300 et un remboursement de −80. Le total net attendu est de 220 MAD. Le test compare chaque écriture, puis le total. Vérifier uniquement le net laisserait passer un export réduit à une seule ligne de 220 MAD, ce qui casserait le rapprochement ligne par ligne.
Conservez ce jeu de données dans le dépôt. Sur une préproduction jetable, chargez la commande, exportez le fichier et passez-le au test. Consignez la version exacte du plugin et les versions de WordPress, de WooCommerce et de PHP de chaque combinaison testée. Ce relevé évite d’annoncer une compatibilité générale à partir d’un seul environnement. Pour reproduire le cas à la main, créez les trois fichiers suivants. Le point-virgule sépare les champs de cet exemple et les montants sont exprimés en centimes.
| Fichier | En-tête | Lignes suivantes |
|---|---|---|
attendu.csv |
type;montant_centimes |
vente;30000 puis remboursement;-8000 |
sans-remboursement.csv |
type;montant_centimes |
vente;30000 |
net-seul.csv |
type;montant_centimes |
vente;22000 |
Un comparateur en Python 3.11, sans dépendance externe, suffit pour le scénario. Il vérifie les lignes sans imposer leur ordre et conserve les doublons éventuels dans la comparaison.
import csv
import sys

def lire_ecritures(chemin):
    with open(chemin, encoding="utf-8", newline="") as fichier:
        lignes = csv.DictReader(fichier, delimiter=";")
        return sorted(
            (ligne["type"], int(ligne["montant_centimes"])) for ligne in lignes
        )

attendu = lire_ecritures("attendu.csv")
observe = lire_ecritures(sys.argv[1])
total = sum(montant for _, montant in observe)
if observe != attendu or total != 22000:
    sys.exit(f"ÉCHEC · net {total / 100:.2f} MAD · lignes {observe}")
print("OK · 2 écritures · net 220.00 MAD")
Enregistrez le script sous controle_export.py. Exécutez
python3 controle_export.py attendu.csv, puis répétez avec
les deux autres fichiers. Le premier cas doit réussir. Les deux
mutations doivent échouer, y compris celle qui conserve le bon total.
Dans le dépôt du client, passez au script l’export produit par le plugin
à partir des données fictives.
Ce que l’agent peut faire après un échec
Laissez GitHub Actions exécuter les tests et conserver leurs
résultats. Dans un dépôt de test, déclenchez ensuite le triage à la
demande sur un journal nettoyé. Demandez à l’agent de relever le commit,
la combinaison de versions, le test en échec et le lien vers
l’exécution. Donnez-lui une seule action d’écriture, l’ouverture d’un
ticket via safe-outputs.create-issue. L’équipe vérifie le
ticket, décide de la correction, relance le test et autorise la fusion.
Les journaux transmis à l’agent utilisent des données fictives. La
chaîne de test ne reçoit aucun secret de production et n’exécute aucun
code de fork dans un workflow privilégié.
Comparez le ticket de l’agent à une notification classique contenant le nom du test et le lien vers le journal. Sur un échantillon d’exécutions, relevez le temps de triage humain, les diagnostics erronés et le coût du modèle. Si la notification suffit, le client garde le contrôle de compatibilité et économise l’inférence. Disponibilité générale de GitHub Agentic Workflows, 28 octobre 2026, anglais · Configuration et facturation, documentation GitHub en espagnol
Simulation du forfait après la mise en place
Hypothèses fictives. Le forfait mensuel est de 900 MAD pour un dépôt,
deux combinaisons de versions et trois heures de contrôle et de triage.
La mise en place des tests et les corrections font l’objet d’un devis
séparé. Le temps du prestataire est valorisé à 180 MAD par heure. Le
budget du mois réserve 100 MAD à l’exécution des tests et 40 MAD à
l’agent. À trois heures, les coûts directs simulés sont de 680 MAD et le
solde avant frais généraux et impôts est de 220 MAD. À cinq heures sans
avenant, le solde tombe à −140 MAD. Avec ces dépenses techniques, le
seuil est de (900 − 100 − 40) ÷ 180, soit environ 4 h 13.
Ces chiffres constituent une simulation interne de chiffrage.
Le test commercial tient en une proposition. Demandez à une agence de fournir un incident d’export déjà corrigé et de payer un audit court qui reproduit l’échec sur une ancienne version et vérifie la version corrigée. Le forfait prend ensuite en charge les combinaisons de versions convenues et un relevé des tests. Un changement de format comptable, une nouvelle version majeure ou une intervention urgente demande un périmètre distinct.
À lire sur Geekkech · Tester un prototype IA avant livraison